文字列の編集
18.2 文字列の編集
ここまでで、WRITE命令を用いた基本的な出力方法を確認しました。しかし、実際のプログラムでは、データベースから取得した値をそのまま表示することはあまりありません。
多くの場合、表示する前にデータを「見やすい形」に整える必要があります。
例えば、次のような処理を行います。
・姓と名を連結して氏名として表示する
・区切り文字で分割されたデータから必要な部分だけを取り出す
・不要な空白を削除する
・特定の文字を別の文字へ置き換える
このように、表示するためにデータの形を整える処理を、本章では「表示データの編集」と呼びます。
この編集処理を理解するために、まずはABAPにおけるデータの種類として、「文字列」と「バイト列」について確認します。
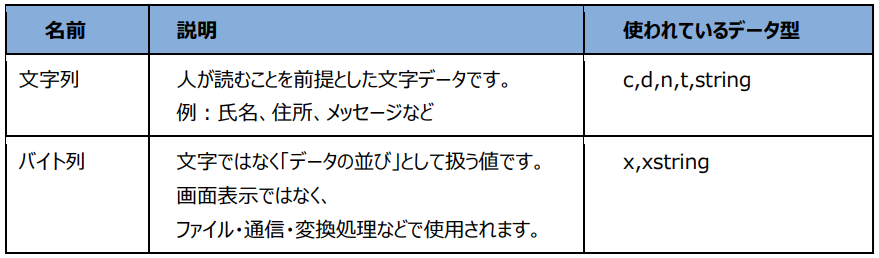
本章で扱う「表示データの編集」は、主に文字列に対して行う処理です。
そのため、以降のサンプルコードでは、文字列型のデータを中心に扱います。
文字列に対しては、次のような編集処理を行う命令が用意されています。
・文字列の連結(CONCATENATE)
・文字列の分割(SPLIT)
・文字列の検索(FIND)
・文字列の置換(REPLACE)
・文字列の整形(SHIFT / CONDENSE / OVERLAY)
・文字列の部分取得(オフセット)
以降では、これらの命令を順に確認していきます。
文字列の連結(CONCATENATE・文字列テンプレート)
文字列を連結する方法には、従来からある CONCATENATE命令(旧構文)と、ABAP 7.4以降でよく使われる 文字列テンプレート(新構文)があります。
まずはCONCATENATE命令を使って、複数の文字列を1つにまとめる基本的な考え方を確認します。
続いて、同じ処理を文字列テンプレートで記述し、より簡潔で読みやすい書き方も紹介します。
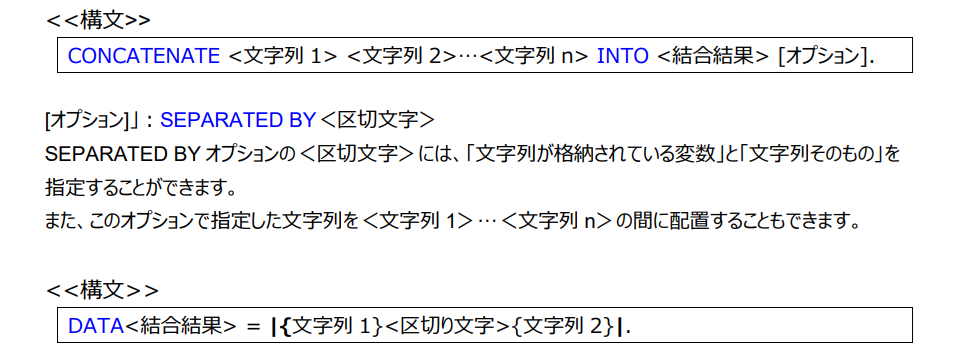
新構文では、視覚的に文字列を連結することができます。また、変数(定数)は { 変数(定数)名 } と記述します。
サンプルコード
REPORT Z_SAMPLE182_CONCATENATE.

DATA:
  LV_TEXT1 TYPE C LENGTH 3 VALUE 'ABC',
  LV_TEXT2 TYPE C LENGTH 3 VALUE 'DEF',
  LV_TEXT3 TYPE C LENGTH 2 VALUE 'GH'.

DATA:
  LV_OLD_NO_SEP TYPE STRING, " 旧構文:区切りなし
  LV_OLD_SEP    TYPE STRING. " 旧構文:区切りあり

" 旧構文:CONCATENATE(区切りなし)
CONCATENATE LV_TEXT1 LV_TEXT2 LV_TEXT3
  INTO LV_OLD_NO_SEP.

" 旧構文:CONCATENATE(区切り文字あり)
CONCATENATE LV_TEXT1 LV_TEXT2 LV_TEXT3
  INTO LV_OLD_SEP
  SEPARATED BY '_'.


" 新構文:文字列テンプレート(区切りなし / 区切りあり)
DATA(LV_NEW_NO_SEP) = |{ LV_TEXT1 }{ LV_TEXT2 }{ LV_TEXT3 }|.
DATA(LV_NEW_SEP)    = |{ LV_TEXT1 }_{ LV_TEXT2 }_{ LV_TEXT3 }|.

" 結果出力
WRITE: / '--- Old (CONCATENATE) ---',
       / |No Sep : { LV_OLD_NO_SEP }|,
       / |Sep    : { LV_OLD_SEP }|.

SKIP.

WRITE: / '--- New (String Template) ---',
       / |No Sep : { LV_NEW_NO_SEP }|,
       / |Sep    : { LV_NEW_SEP }|.
結果
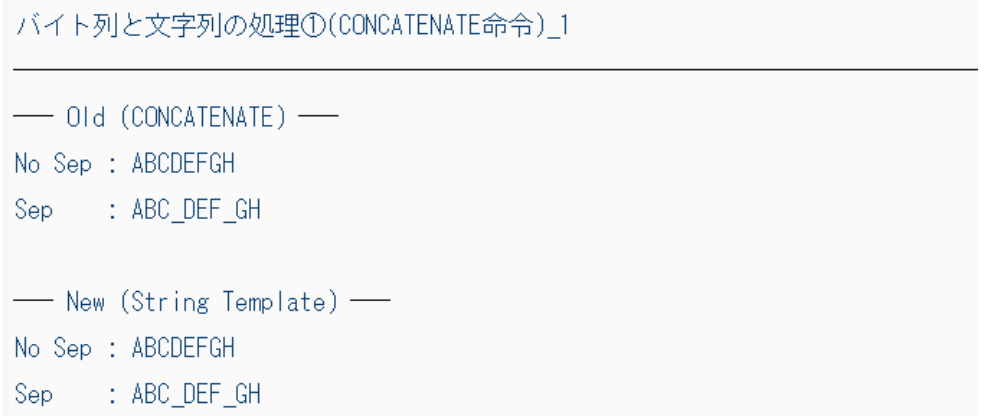
実行結果は同じになります。
文字列の分割(SPLIT)
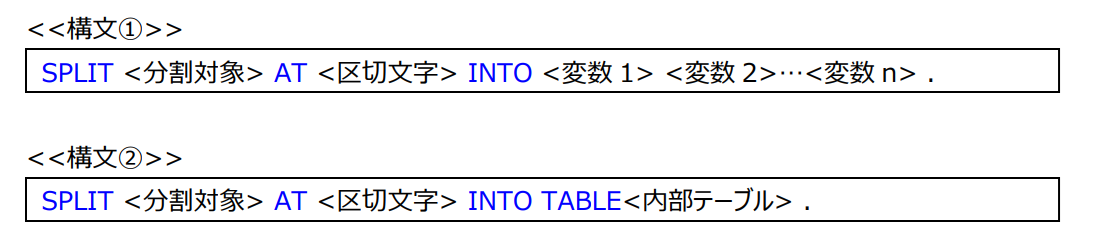
SPLIT命令は、1つの文字列を区切り文字によって分割する命令です。
外部システムやファイルから取得したデータは、「,」や「/」などの区切り文字を含む1つの文字列として渡されることがあります。
例:”YAMADA,TARO,TOKYO”
このままでは各項目として扱えないため、氏名や住所などを個別のデータとして取り出す必要があります。
このような「1つの値を複数の意味ある項目に分ける」場合に使用します。
<分割対象>の文字列から<区切文字>を検索し、区切文字前後部分を<変数1>…<変数n>
または、内部テーブルに格納します。
格納項目数が不足した場合は、残りの文字列が区切文字を含んだまま最後の項目に格納されます。
サンプルコード
REPORT Z_SAMPLE182_SPLIT.
DATA:
  WK_TEXT(20)    TYPE C,
  WK_TEXT1(10)  TYPE C,
  WK_TEXT2(10)  TYPE C,
  WK_TEXT3(10)  TYPE C.

CONSTANTS:
  CNS_MARK TYPE C VALUE  '/'.

WK_TEXT = 'ABC/DEF/GHI/JKL'.

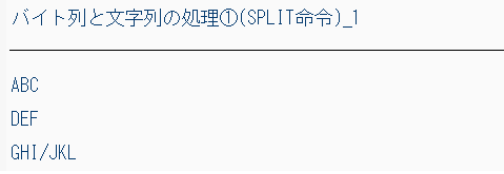
SPLIT WK_TEXT AT CNS_MARK INTO WK_TEXT1 WK_TEXT2 WK_TEXT3.

WRITE:  WK_TEXT1,
        /  WK_TEXT2,
        /  WK_TEXT3.
結果
文字列の検索(FIND)
FIND命令は、文字列の中に特定の文字や文字列が含まれているかを確認する命令です。
表示データを編集する際には、値の内容によって処理を分岐したい場合があります。
条件分岐と組み合わせて使用されることが多い命令です。

サンプルコード
REPORT Z_SAMPLE182_FIND.

DATA(LV_TEXT) = 'ABAP PROGRAM'.

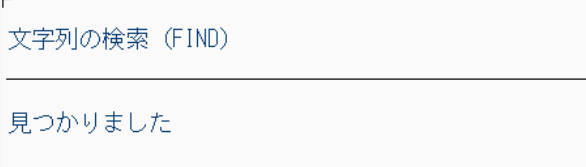
FIND 'ABAP' IN LV_TEXT.

IF SY-SUBRC = 0.
  WRITE: / '見つかりました'.
ELSE.
  WRITE: / '見つかりません'.
ENDIF.
結果
文字列の置換(REPLACE)
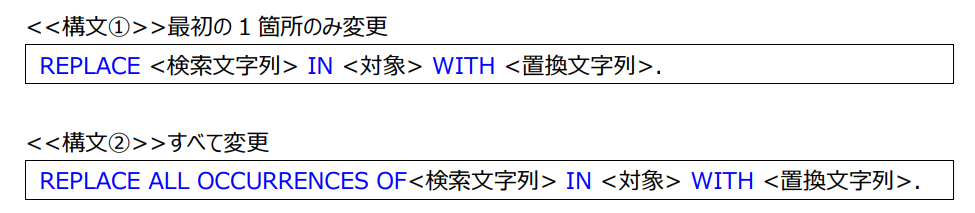
REPLACE命令は、指定した文字列を別の文字列に変更する命令です。
ただし、基本形の REPLACE は 最初に見つかった1箇所のみ を置換します。
つまり、同じ文字が複数存在していても、すべては変更されません。
すべて置換したい場合は ALL OCCURRENCES OF を指定します。
サンプルコード
REPORT Z_SAMPLE182_REPLACE.

DATA(LV_TEXT) = '2026-01-01'.

" 最初の1箇所のみ置換される
REPLACE '-' IN LV_TEXT WITH '/'.

WRITE: / '1回のみ置換:', LV_TEXT.
" → 2026/01-01 になる

" すべて置換する場合
REPLACE ALL OCCURRENCES OF '-' IN LV_TEXT WITH '/'.

WRITE: / '全て置換:', LV_TEXT.
" → 2026/01/01 になる
結果

文字列の整形(SHIFT / CONDENSE / OVERLAY)
これら3つの命令はすべて「文字列の見た目を整える」命令ですが、目的がそれぞれ異なります。
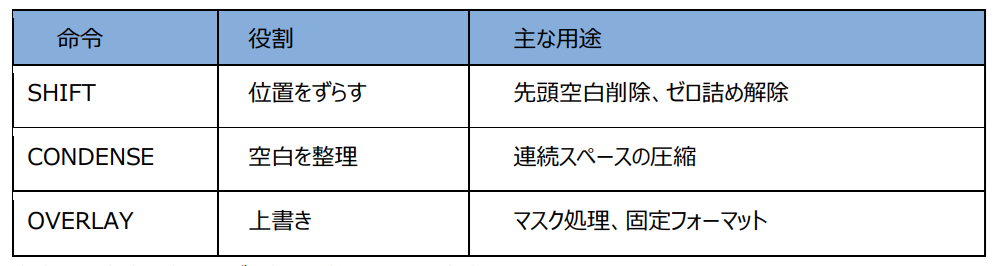
文字列の内容を変更せず、表示を整えるための命令です。 主に画面表示や帳票出力の見た目を調整する目的で使用します。
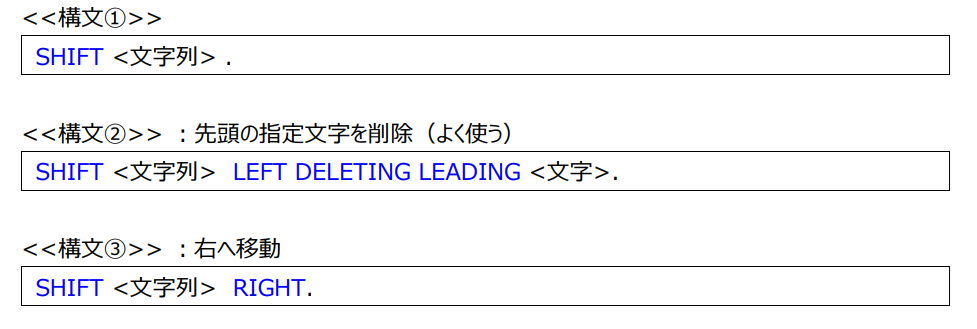
SHIFT(位置移動)
文字列全体を左右に移動させます。特に「先頭空白の削除」でよく使います。
サンプルコード
REPORT Z_SAMPLE182_SHIFT.

DATA(lv_text) = '   ABAP'.

" そのまま表示
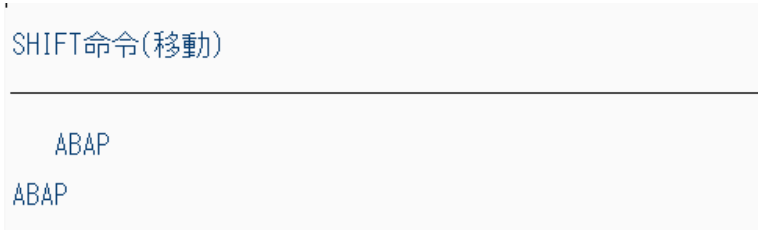
WRITE: / lv_text.   " →    ABAP

" 先頭の空白を削除
SHIFT lv_text LEFT DELETING LEADING space.

WRITE: / lv_text.   " → ABAP
結果
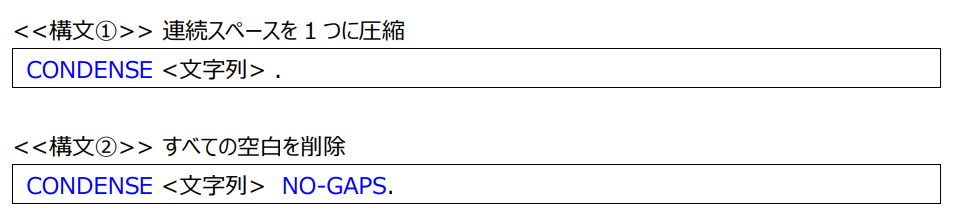
CONDENSE(空白の圧縮)
文字列全体を左右に移動させます。特に「先頭空白の削除」でよく使います。
サンプルコード
REPORT Z_SAMPLE182_CONDENSE.

DATA(LV_TEXT) = 'ABAP    PROGRAM    TEST'.

CONDENSE LV_TEXT.
WRITE: / LV_TEXT.   " ABAP PROGRAM TEST

CONDENSE LV_TEXT NO-GAPS.
WRITE: / LV_TEXT.   " ABAPPROGRAMTEST
結果

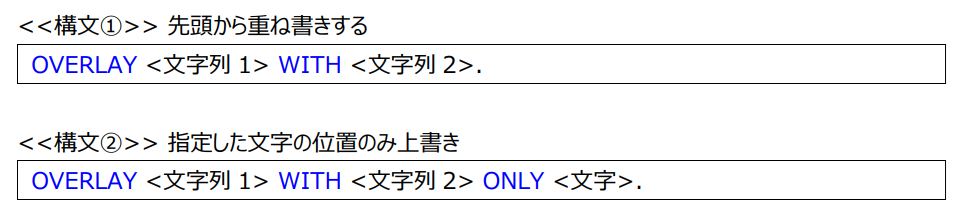
OVERLAY(上書き)
OVERLAY命令は文字列の一部を上書きする旧来の命令です。
現在の開発では文字列テンプレートを使用する方法が一般的であり、新規開発で使用されることはほとんどありません。
ただし、既存プログラムでは使用されているため、内容を読み取れるように基本的な動作のみを確認します。
サンプルコード
※結果は表示されません。REPORT Z_SAMPLE182_OVERLAY. DATA(LV_TEL) = '09012345678'. DATA(LV_MASK) = '****'. "3文字目から4文字を上書き OVERLAY LV_TEL+2(4) WITH LV_MASK. WRITE: / LV_TEL. " 09****45678
文字列の部分取得(オフセット)
文字列の一部を取り出したり、特定位置に上書きしたい場合は オフセットを使用します。
ABAPのオフセット指定は、+開始位置(長さ) の形で表します。開始位置は 0開始です(先頭が0)。
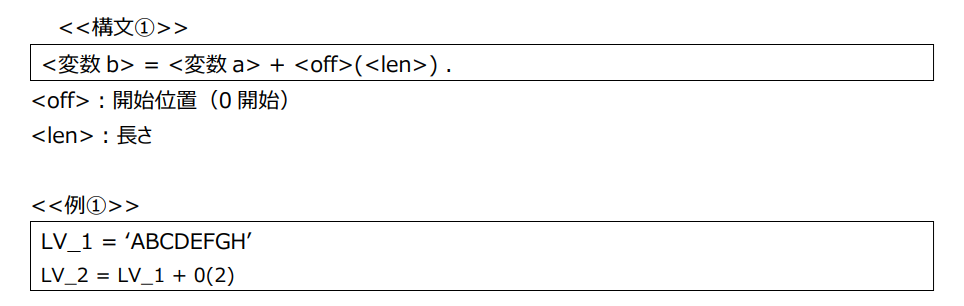
上記の場合は、変数LV_1の1桁目から2桁分、つまり ‘AB’がLV_2に代入されます。
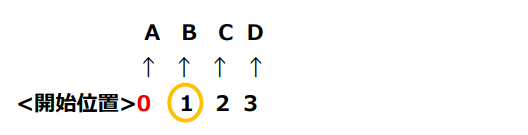
「0(2)」の 0 が先頭から何バイトを指すことになるので、
開始位置は0,、括弧内の2が長さということになります。
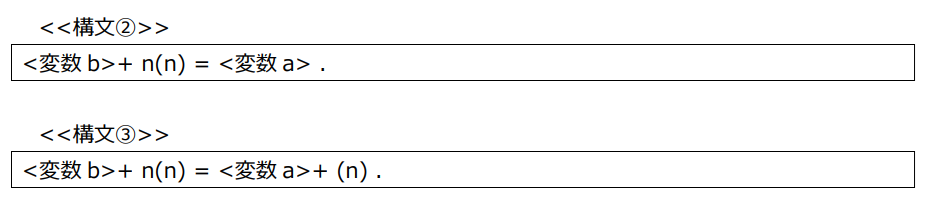
上記の例を含め、オフセット代入には様々なバリエーションがあります。 代入先の開始位置と長さを指定する場合は、次の通りです。
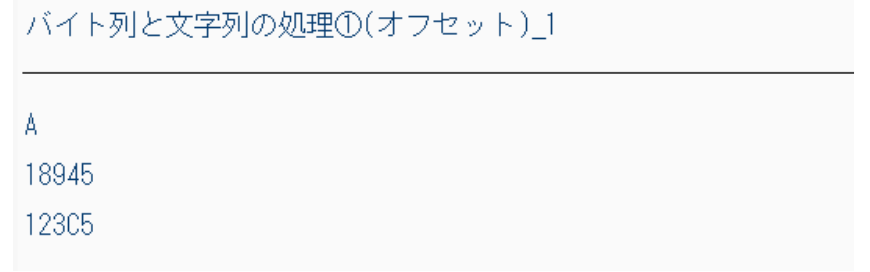
サンプルコード
REPORT Z_SAMPLE195_OFFSET.

DATA:
  LV_TEXT1 TYPE C LENGTH 8 VALUE 'ABCDEFGH',
  LV_TEXT2 TYPE C LENGTH 1,
  LV_NUM1  TYPE C LENGTH 2 VALUE '89',
  LV_NUM2  TYPE C LENGTH 5 VALUE '12345',
  LV_CHAR1 TYPE C LENGTH 8 VALUE 'ABCDEFGH',
  LV_CHAR2 TYPE C LENGTH 5 VALUE '12345'.

" ① 先頭1文字を取り出す(開始0、長さ1)
LV_TEXT2 = LV_TEXT1+0(1).
WRITE: / LV_TEXT2.

" ② lv_num2 の 2文字目から2桁を、lv_num1 で上書き(開始1、長さ2)
LV_NUM2+1(2) = LV_NUM1.
WRITE: / LV_NUM2.

" ③ lv_char1 の 3文字目(開始2)を1文字取り出し、lv_char2 の 4文字目(開始3)へ代入
LV_CHAR2+3(1) = LV_CHAR1+2(1).
WRITE: / LV_CHAR2.
結果